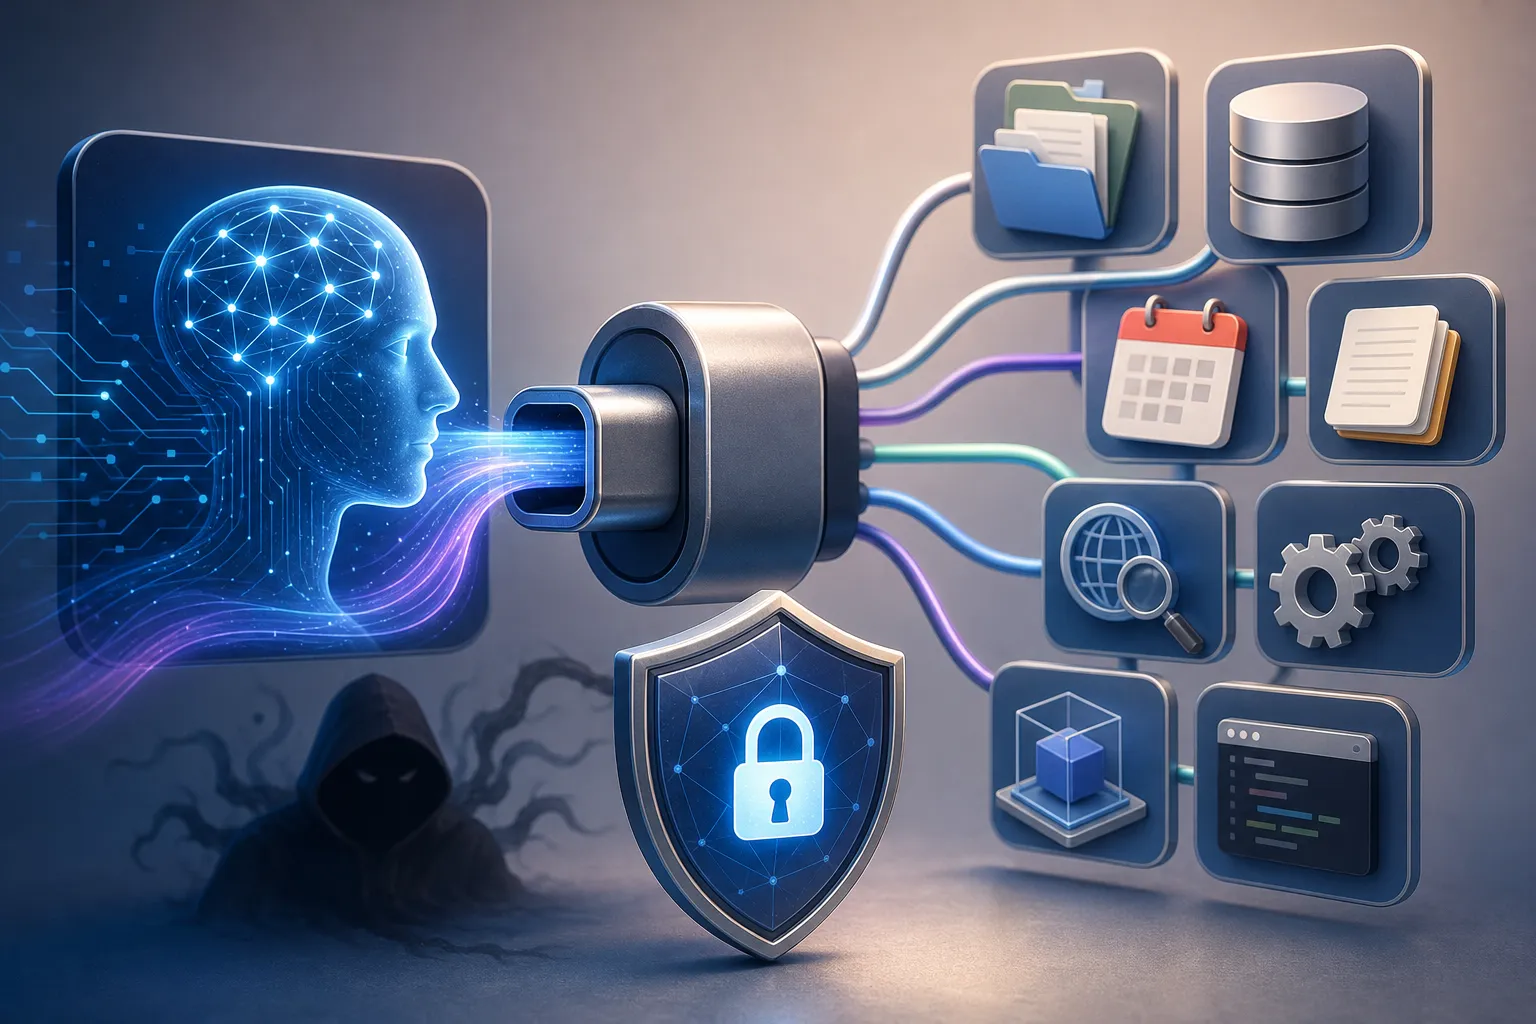
Il Model Context Protocol (MCP) emerge come una risposta strategica a uno dei limiti più significativi dei modelli linguistici di frontiera: l'isolamento dai dati. Nonostante i rapidi progressi nelle capacità di ragionamento e nella qualità delle risposte, molti sistemi di intelligenza artificiale rimangono intrappolati all'interno di silos informativi e sistemi legacy. Tradizionalmente, l'integrazione di ogni nuova fonte di dati richiedeva implementazioni personalizzate, rendendo estremamente difficile la scalabilità di sistemi realmente connessi. L'MCP mira a risolvere questa frammentazione introducendo un protocollo unico e aperto che standardizza il collegamento tra assistenti IA e i sistemi in cui risiedono i dati, come repository di contenuti, strumenti aziendali e ambienti di sviluppo.
Dal punto di vista tecnico, l'MCP adotta un'architettura client-server lineare. In questo ecosistema, l'MCP Host è l'applicazione IA (come Claude Desktop o Claude Code) che coordina l'operazione. L'host stabilisce connessioni con uno o più MCP Server attraverso la creazione di MCP Client dedicati. Mentre i server locali che utilizzano il trasporto STDIO servono tipicamente un singolo client, i server remoti basati su HTTP Streamable possono supportare molteplici client contemporaneamente. L'obiettivo fondamentale è permettere agli sviluppatori di esporre i propri dati tramite server MCP o di costruire applicazioni (client) capaci di interfacciarsi con tali server, facilitando una connessione sicura e bidirezionale.
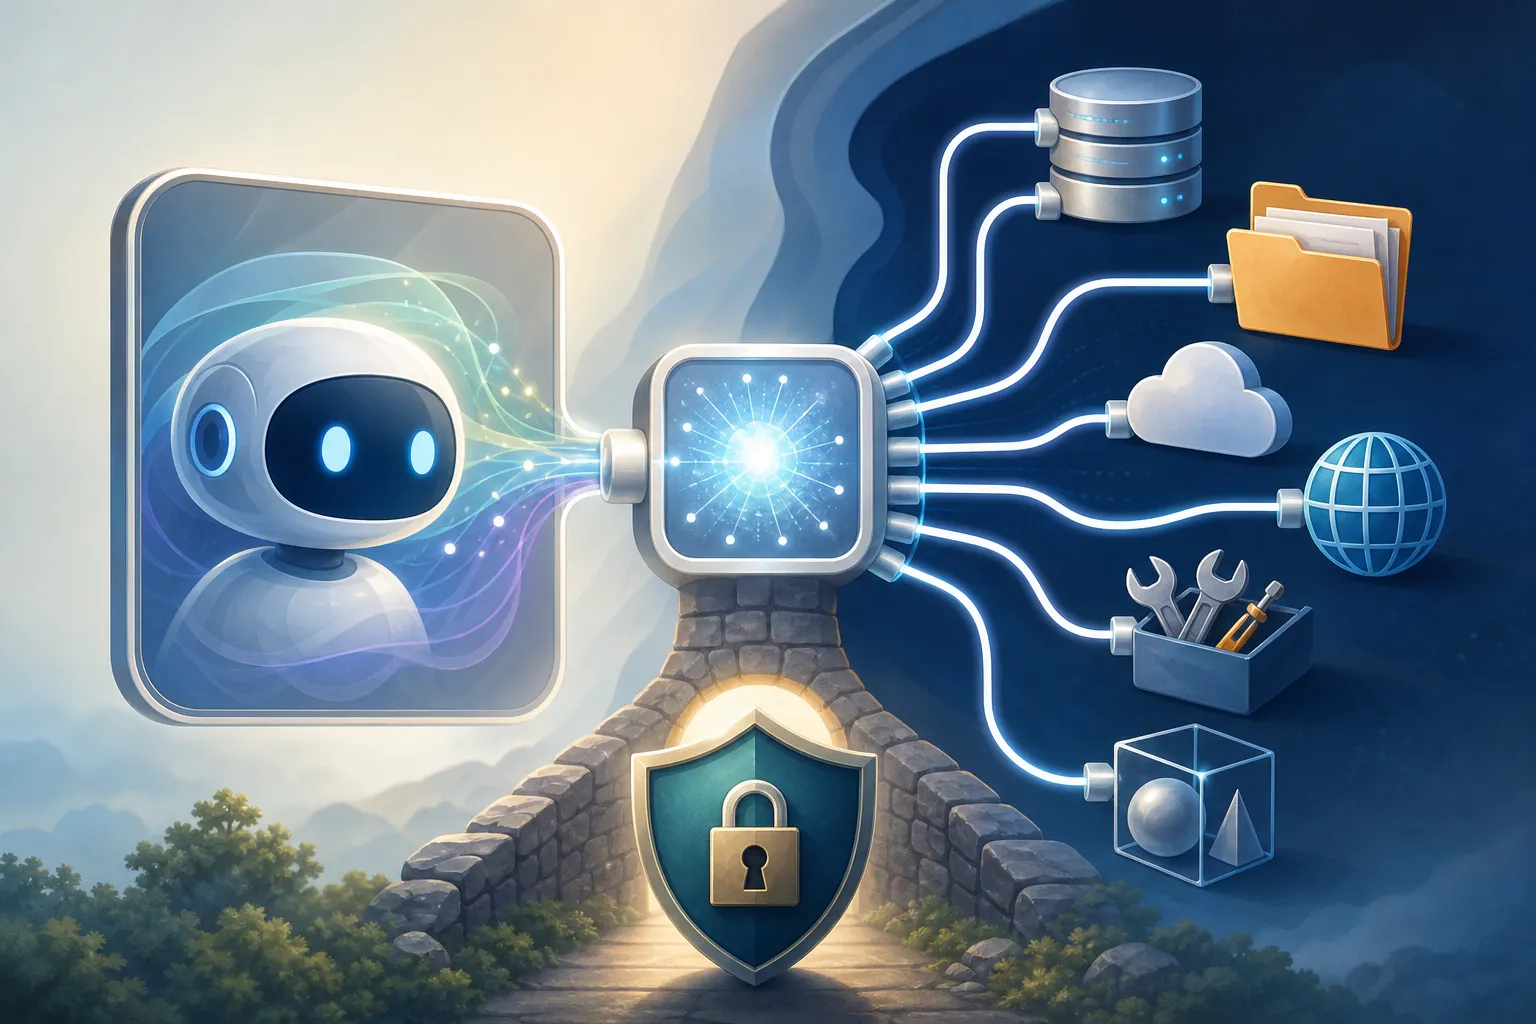
Il valore aggiunto dell'MCP può essere paragonato a quello di una porta USB-C per le applicazioni di intelligenza artificiale. Proprio come lo standard USB-C ha unificato il collegamento tra dispositivi elettronici diversi, l'MCP fornisce un modo standardizzato per connettere l'IA a fonti esterne, tra cui file locali, database, motori di ricerca e flussi di lavoro specializzati. Questo approccio riduce drasticamente i tempi e la complessità di sviluppo per chi crea agenti IA, poiché permette di «costruire una volta e integrare ovunque». Le applicazioni pratiche spaziano da assistenti personalizzati capaci di accedere a Google Calendar e Notion a chatbot aziendali che analizzano database distribuiti, fino a modelli in grado di interagire con software di design 3D come Blender.
Dal confronto delle informazioni fornite emerge una coerenza tra le fonti riguardo alla natura open source del protocollo e al suo supporto da parte di vari strumenti. Mentre Anthropic sottolinea l'efficacia di Claude 3.5 Sonnet nella creazione rapida di implementazioni MCP e menziona l'integrazione in strumenti come Zed e Replit, la documentazione tecnica di modelcontextprotocol.io amplia lo spettro citando il supporto di Visual Studio Code, Cursor e ChatGPT. È interessante notare come l'MCP non detti le modalità con cui le applicazioni IA utilizzano i modelli linguistici di grandi dimensioni (LLM) o gestiscono il contesto fornito, concentrandosi esclusivamente sul protocollo di scambio del contesto stesso.
Tuttavia, l'implementazione di tale protocollo non è priva di rischi. La documentazione sulla sicurezza evidenzia vulnerabilità specifiche, come il problema del «Confused Deputy». Questo rischio si verifica quando gli aggressori sfruttano server proxy MCP che si connettono ad API di terze parti, utilizzando l'estensione di identificativi client statici e cookie di consenso per ottenere codici di autorizzazione senza il consenso dell'utente. Per mitigare tali rischi, è fondamentale che l'implementazione dell'MCP sia accompagnata dalle specifiche di autorizzazione e dalle migliori pratiche di sicurezza OAuth 2.0.
La copertura delle informazioni disponibili presenta comunque alcuni limiti. Sebbene vengano menzionati SDK per diversi linguaggi di programmazione e strumenti di sviluppo come l'MCP Inspector, non vengono forniti i dettagli tecnici specifici delle implementazioni per ogni singolo linguaggio. Inoltre, mentre vengono citati early adopter come Block e Apollo, mancano dettagli quantitativi sulle prestazioni o sull'impatto reale in termini di riduzione dei tempi di sviluppo. La documentazione si concentra principalmente sulla struttura e sulle potenzialità, rimandando ai singoli SDK di linguaggio per i dettagli specifici di implementazione.